Содержание
Что такое Chroma
Chroma - это open source векторная база данных. Она работает с векторами и находится в открытом доступе. Любой желающий может начать использовать эту базу данных для хранения своих векторов.
Chroma - это нативный для Python инструмент, который создан для того, чтобы быстро внедриться и начать пользоваться векторными базами данных. Установка достаточно простая. Устанавливается виртуальное окружение Python, и вы можете пользоваться уже этой базой данных.
Chroma работает не только с Python, но Python - это основной нативный инструмент, с которым эта база данных может взаимодействовать.
Сценарии использования
Основные сценарии использования Chroma - это семантический поиск. Мы ищем не по точному вхождению какого-то слова. Например, мы ищем слово "хлеб". Мы будем искать не только по слову "хлеб", но и по всем смысловым значениям, которые находятся рядом.
Например, векторная база данных по слову "хлеб" может выдать:
- зерно
- завод
- хлебопекарню
Это все понятия, которые находятся близко друг к другу. Мы ищем не только "хлеб", "хлебный" и подобные вхождения. Мы ищем семантические значения, которые будут подходить под наш поиск. Эту базу данных можно использовать для поиска по документации, по базе знаний, по статьям.
Часто Chroma используют для RAG-систем и ассистентов. База данных входит в систему RAG, и вы можете использовать её для хранения эмбеддингов. Большая информация разбивается на куски, переводится в векторы. Эти векторы хранятся в векторной базе данных Chroma.
Поскольку AI и ассистенты имеют ограниченный контекст, мы выбираем из этой векторной базы данных куски, которые по смысловой нагрузке больше всего подходят к запросу пользователя. Эти данные выдаются ассистенту, и он уже формирует ответ на основе этого контекста.
Также Chroma может использоваться для систем рекомендаций, подбора похожего контента, статей, продуктов и для кластеризации. Это более специфичные примеры использования, которые тоже имеют место быть.
Как ChromaDB ищет
Поиск в Chroma устроен в три шага. Каждый документ при добавлении превращается в вектор - эмбеддинг, набор чисел, который описывает смысл текста. Векторы складываются в индекс. Когда приходит запрос, он тоже превращается в вектор, и Chroma ищет в индексе векторы, которые лежат ближе всего к нему. Ближе по числам значит ближе по смыслу - поэтому на запрос «хлеб» находятся и пекарня, и зерно.
Установка
pip install chromadbОтдельный сервер для начала не нужен: база работает прямо внутри вашей программы на Python. Как подключаться к базе - в памяти, с сохранением на диск или к серверу по сети - разобрано в уроке Что такое Client ChromaDB и их виды.
Кто превращает текст в векторы
Если не указать свою модель, Chroma берёт встроенную - all-MiniLM-L6-v2 из библиотеки Sentence Transformers. Она работает локально, без ключей API и без оплаты. При первом использовании Chroma сама скачивает файлы модели в папку ~/.cache/chroma/onnx_models, поэтому первый запуск идёт заметно дольше следующих.
У встроенной модели есть три особенности, которые стоит знать заранее:
- каждый текст превращается в вектор из 384 чисел;
- модель обучали на английских текстах, русский она понимает заметно хуже - похожие по смыслу русские фразы могут оказаться далеко друг от друга;
- длинный текст обрезается примерно до 256 токенов, остальное в вектор не попадает. Поэтому большие документы перед загрузкой режут на куски (чанки), и каждый кусок хранится отдельной записью.
Для русских текстов к коллекции подключают другую модель эмбеддингов, например от Google или OpenAI. Как это сделать, показано в курсе Chromadb.
Как находятся похожие документы
Векторы хранятся в индексе HNSW (Hierarchical Navigable Small World). Это граф, по которому Chroma быстро добирается до ближайших соседей запроса, не сравнивая его с каждой записью коллекции. Поиск приблизительный: на больших коллекциях скорость важнее гарантии, что найден самый-самый близкий документ, и на практике разница почти не заметна.
Близость меряется расстоянием между векторами. Способ подсчёта задаётся при создании коллекции:
- l2 - квадрат обычного (евклидова) расстояния, используется по умолчанию;
- cosine - косинусное расстояние, смотрит на направление векторов, а не на их длину; часто выбирают для текстов;
- ip - через скалярное произведение векторов.
Что возвращает query()
Ответ на запрос - словарь, в котором каждое поле устроено как список списков. Внешний список - по запросам: в query() можно передать сразу несколько текстов, и на каждый придёт свой набор результатов. Внутренний список - найденные документы, от самого близкого к самому дальнему. Если не указать, сколько нужно результатов (n_results), Chroma вернёт 10 на каждый запрос.
Так выглядит ответ на один запрос с двумя найденными документами (числа для примера):
{
    'ids': [['2', '1']],
    'documents': [['Рецепт хлеба на закваске', 'Как выбрать муку для выпечки']],
    'metadatas': [[None, None]],
    'distances': [[0.41, 0.87]],
    'embeddings': None,
    ...
}
ids приходят всегда, documents, metadatas и distances - по умолчанию, а сами векторы (embeddings) - только если попросить их явно: они большие и для ответа обычно не нужны.
Что значит distance
distance - это расстояние, а не процент сходства: чем меньше число, тем ближе документ к запросу по смыслу, 0 - полное совпадение. Само значение зависит от модели эмбеддингов и способа подсчёта, поэтому готового порога вроде «всё, что меньше 0,5, подходит» нет. Порог, после которого документ уже не по теме, подбирают на своих данных: задают несколько типичных вопросов и смотрят, на каком расстоянии начинаются лишние ответы.
В RAG-системе именно эти найденные куски текста уходят в контекст языковой модели, и она отвечает по ним. Чем точнее поиск, тем меньше лишнего попадает в контекст и тем точнее ответ.
Интеграция и ограничения
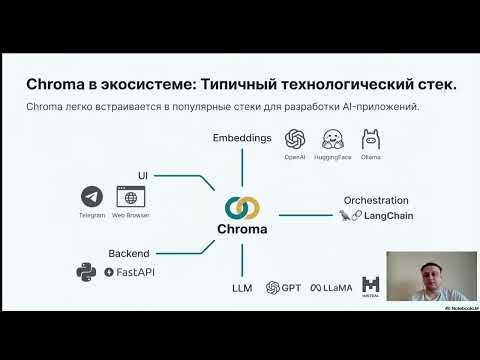
Chroma - это инструмент, который позволяет связывать различные узлы систем, взаимодействующих с искусственным интеллектом. Она хранит эмбеддинги, которые были созданы с помощью OpenAI, Ollama и других инструментов. Если LLM-модель запросит какие-то данные, Chroma выдаёт эти данные.
Также существует тесная связь с библиотекой LangChain. Там есть инструменты, которые позволяют более эффективно работать с этой базой данных. Пользовательский интерфейс может быть реализован как Telegram-бот, веб-браузер и так далее.
Chroma получила широкое распространение в связи с появлением систем искусственного интеллекта. Нужно где-то хранить дёшево векторные данные, и Chroma - это хорошее решение, если вы разрабатываете на Python.
Нужно понимать, что Chroma не является единственной векторной базой данных. Это лишь одно из решений, которое вы можете применить в своей работе. Есть некоторые архитектурные ограничения:
- не оптимизирована для систем с высокой нагрузкой
- ограниченная масштабируемость
- не предназначена для хранения огромного объёма данных
- не лучший выбор для десятков миллионов векторов
- зависимость от экосистемы Python
Chroma хорошо подходит для проектов, где нужно:
- запустить MVP
- быстро попробовать что-то и посмотреть, как это будет работать
- локальные RAG-системы
- чат-боты
- офлайн-решения
- демо-приложения
- проекты с небольшими и средними объёмами данных
Для high-production систем, если вы выкладываете это на продакшн-сервер, стоит поискать другие векторные базы данных. Если у вас большие объёмы (миллионы, десятки миллионов векторов), то Chroma может не подойти. Если требуется отказоустойчивая архитектура или вы пишете программу не на Python, лучше рассмотреть другие варианты.
Chroma - это простой и удобный способ добавить семантический поиск и RAG-систему в ваш проект без сложной инфраструктуры, которую нужно разворачивать.

Чтобы оставить сообщение, зарегистрируйтесь/войдите на сайт через:
Email - зарегистрироваться / войти